En bref
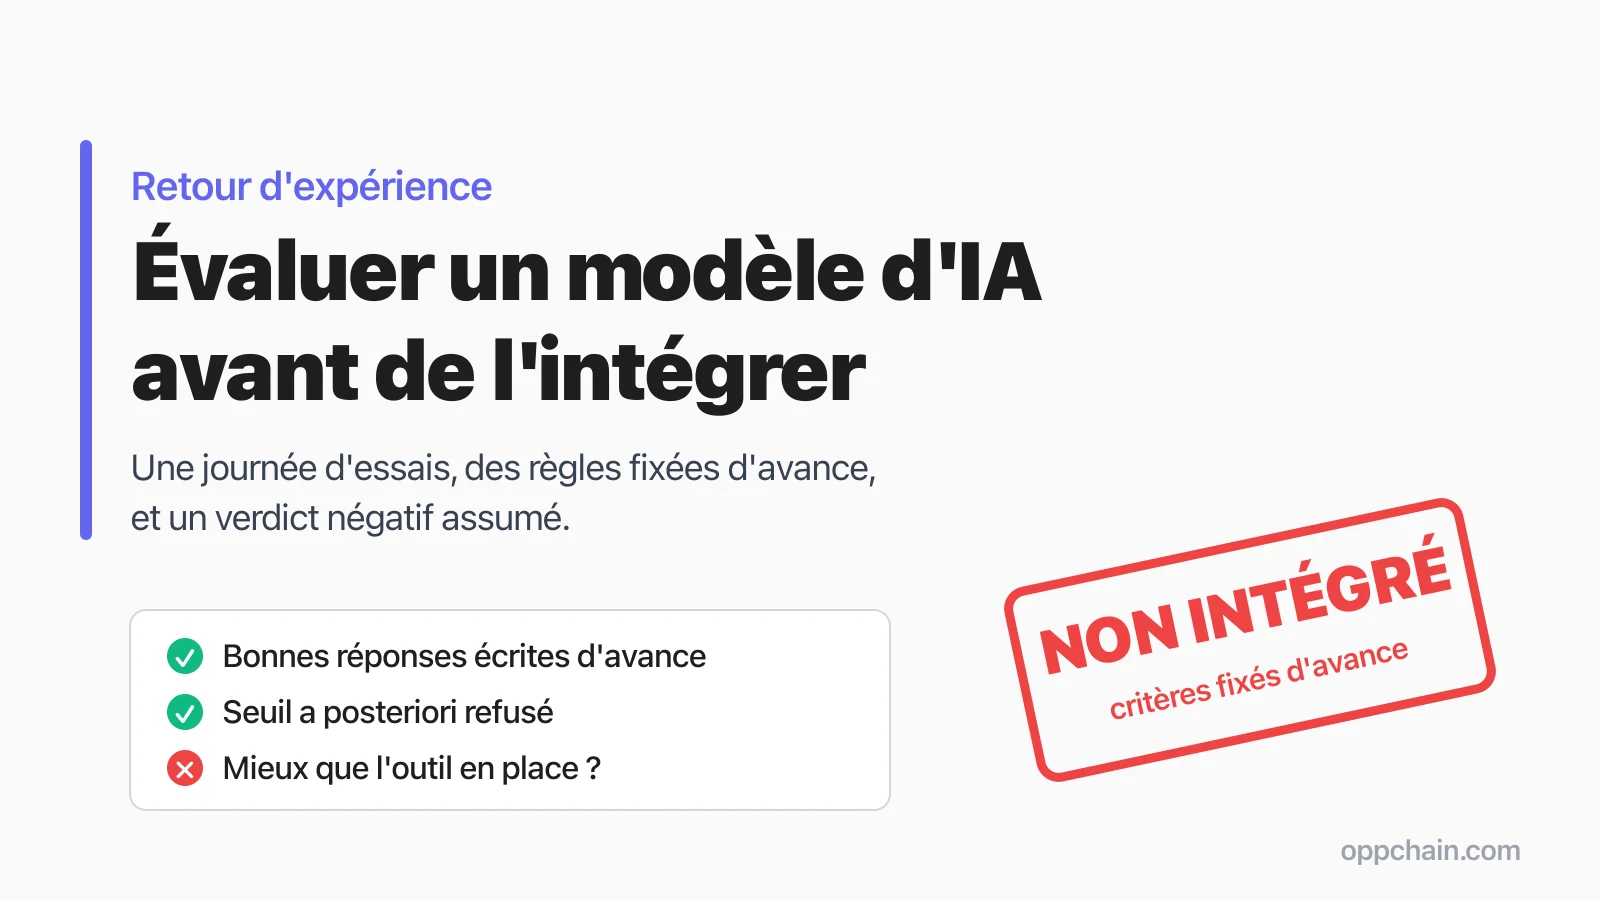
- Une journée, un verdict : le 7 octobre 2026, nous avons évalué Jev, un modèle de décision de TypeSafe, et décidé de ne pas l'intégrer.
- La bonne question : pas « l'outil marche-t-il ? », mais « apporte-t-il plus que ce que nous avons déjà ? »
- La méthode : bonnes réponses et règles fixées avant les appels, une seule variable changée à la fois, comparaison avec l'outil en place. Appliquée de plus en plus strictement, et pleinement sur le dernier essai.
- Le défaut décisif : sur notre essai de couverture des tests, Jev a répondu « oui » avec assurance alors que la preuve ne lui avait pas été montrée. Un modèle qui ne sait pas dire « je ne sais pas » ne peut pas servir de preuve.
- Un « non » est un résultat : il évite d'intégrer et de maintenir un composant sans valeur démontrée.
La plupart des retours d'expérience sur l'IA racontent une adoption. Celui-ci raconte un refus.
Le 7 octobre 2026, nous avons consacré une journée à évaluer Jev, un modèle d'IA de la société américaine TypeSafe. Le soir, la décision était prise : nous ne l'intégrons pas. Sur nos contrôles de code, il ne démontrait pas d'avantage sur l'outil déjà en place, et dans un essai clé il répondait avec assurance alors que l'information lui manquait.
Ce n'est pas un échec. Cette journée nous a évité d'ajouter, puis de maintenir, un composant dont la valeur n'était pas démontrée. Et la méthode qui nous a conduits à ce verdict vaut pour n'importe quel outil d'IA qu'une PME envisage d'ajouter à ses processus.
La question que nous nous posions
Chez Oppchain, nous développons nos applications avec Claude Code, l'assistant de programmation d'Anthropic. Notre chaîne de production comporte de nombreux contrôles. Ce code correspond-il bien à la demande ? Ce test vérifie-t-il vraiment l'exigence qu'il prétend couvrir ? Quelles questions faut-il poser lors de la relecture ? Ce sont ces trois contrôles que nous avons confiés à Jev.
La question n'était donc pas « Jev fonctionne-t-il ? » Elle était plus exigeante : Jev apporte-t-il plus que ce que nous avons déjà ? Un composant de plus, c'est un fournisseur de plus, une clé d'accès de plus, des données qui sortent de l'entreprise et du code à maintenir. Il doit le justifier.
Jev en deux paragraphes
Jev ne rédige rien. C'est ce qui le distingue des modèles comme Claude ou ChatGPT. On lui fournit un texte (un extrait de code et une demande, par exemple) et des questions fermées : oui ou non, un choix dans une liste, une note sur une échelle. Il répond par des probabilités : « oui à 82 % ». TypeSafe le présente comme un modèle de décision, conçu pour que des logiciels exploitent directement ses réponses.
Ses atouts sont réels. Il coûte 0,042 dollar par million de jetons envoyés (un jeton vaut un fragment de mot) ; ses réponses ne sont pas facturées. Notre premier essai, 138 appels, a coûté moins d'un centime. Il est rapide : un appel mesuré chez nous a répondu en un quart de seconde, et l'éditeur annonce de 70 à 500 millisecondes. Ses réponses chiffrées s'intègrent facilement dans un programme. Sur le papier, c'était un bon candidat pour automatiser une partie de nos contrôles.
La méthode : fixer les règles avant de regarder
Quatre règles guidaient nos essais. Nous les avons appliquées de plus en plus strictement au fil de la journée, et toutes les quatre sur le dernier essai.
Figer la référence avant le premier appel. Pour chaque cas, la bonne réponse était écrite avant d'interroger Jev. Sur les derniers essais, les seuils de réussite et le verdict associé l'étaient aussi. Un réglage trouvé une fois les résultats connus ne compte pas, même s'il fait passer l'essai.
Changer une seule chose à la fois. Quand l'essai sur la relecture a échoué, nous l'avons refait en ne changeant qu'une variable : la consigne donnée à Jev. Nous avions décidé avant de le relancer que nous nous arrêterions s'il échouait encore.
Comparer à l'existant. Sur l'essai de relecture, Jev a été mis face, sur les mêmes cas, à l'agent de test que nous utilisons déjà avec Claude Code pour relire le code et ses tests. Un outil qui fonctionne mais ne fait pas mieux n'apporte rien.
Accepter le verdict, quel qu'il soit. Un « non » est une réponse aussi valable qu'un « oui ».
Cette discipline s'inspire du pré-enregistrement pratiqué en recherche. Notre version est interne : les règles étaient consignées dans notre historique avant les appels, sans tiers pour l'attester. Elle protège contre le biais le plus courant quand on évalue un outil : chercher, consciemment ou non, le réglage qui donne le résultat espéré.
Une précision dès maintenant : nous travaillons au quotidien avec Claude Code, et les cas d'essai comme les bonnes réponses ont été préparés avec Claude. Nous y revenons dans nos limites.
Ce que nous avons observé
Trois usages testés, trois résultats.
Rattacher une modification de code à la demande qu'elle sert. Notre tout premier essai donnait 14 sur 14 : trop facile, le nom du fichier trahissait la réponse. Nous avons donc construit 32 cas difficiles, chacun posé trois fois. Jev donne la bonne réponse 77 % du temps. Ce chiffre demande un repère : sur 17 de ces 32 cas, répondre « aucune demande » était acceptable. Le résultat le plus utile est ailleurs : quand Jev signale qu'une modification ne correspond à aucune demande, il a raison 79 fois sur 100, et il repère 84 % des modifications sans rapport. En revanche, sur un cas, une évolution prévue pour plus tard a été rattachée avec assurance (« oui » à 82 à 88 %) à la demande qu'elle prolonge. Rien dans l'extrait montré ne permettait de savoir qu'elle était prévue pour plus tard : la limite tient autant à la question posée qu'au modèle. Utile comme signal, pas comme preuve.
Juger si un test couvre une exigence. C'est l'essai qui a fait apparaître le défaut décisif. Sur 9 exigences dont la preuve (une donnée de test, une fonction annexe) n'apparaissait pas dans l'extrait montré, Jev a répondu 27 fois « oui, le test couvre l'exigence ». Cela se vérifie en lisant le code. Et quand la seule réponse honnête était « impossible à déterminer », il ne l'a donnée que 9 fois sur 66 réponses. Un premier essai sur cette question, plus simple, avait été encourageant ; rejoué sur un corpus plus exigeant, il a échoué. Les taux exacts restent incertains, car les bonnes réponses de référence ont été produites avec Claude. L'existence du défaut, elle, ne l'est pas.
Choisir les questions utiles lors d'une relecture. 30 cas, dont 15 sans défaut ; les défauts des 15 autres avaient été introduits pour l'essai. La règle fixée d'avance tolérait au plus 5 cas sains signalés à tort. Jev a exposé les 15 défauts, mais il a aussi signalé les 15 cas sains. Nous avons refait l'essai en ne changeant que sa consigne, alignée sur celle de l'agent de test de Claude Code : les fausses alertes ont un peu baissé, mais les 15 cas sains restaient signalés. Ce verdict ne dépend d'aucune comparaison. À titre indicatif, l'agent de test de Claude Code a trouvé les 15 défauts sans signaler aucun cas sain. Cette comparaison lui est toutefois favorable : il voyait les 30 cas d'un coup, dont des paires presque identiques, et les cas avaient été préparés avec Claude.
JEV SUR NOS USAGES, EN QUATRE CHIFFRES
79 %
de justesse quand Jev signale une modification sans demande associée
27
« oui » sans preuve visible, sur 9 exigences
15/15
cas sains signalés en relecture, pour 5 tolérés au plus
< 1 ct
pour les 138 appels du premier essai
Le défaut décisif, net dans l'essai sur les tests, c'est l'assurance sans information : Jev répond avec confiance même quand l'information nécessaire ne lui a pas été montrée, et il dit rarement « je ne sais pas ». Ailleurs, la forme des questions a pesé autant que le modèle : dans l'essai sur la relecture, plusieurs questions de notre catalogue appelaient un « oui » littéralement vrai. TypeSafe présente Jev comme incapable d'« halluciner » : il ne produit pas de texte libre et ne sort jamais du format de réponse prévu. L'éditeur indique lui-même que cette garantie porte sur le format, pas sur un taux mesuré. Elle ne dit rien de l'exactitude de la réponse. Pour un contrôle, la différence est décisive : un modèle qui ne sait pas dire « je ne sais pas » ne peut pas servir de preuve.
Ce que nous n'avons pas fait
C'est la partie la plus difficile.
Un réglage aurait pu sauver Jev. En relevant fortement son seuil d'alerte, c'est-à-dire en ne gardant que ses « oui » les plus assurés, ses fausses alertes tombaient à deux cas sains sur quinze. Jev contient donc un vrai signal : ses probabilités séparaient bien les cas défectueux des cas sains. Mais ce seuil, nous l'avons trouvé après avoir vu les résultats, sur les données mêmes qui servaient à juger. Le retenir, c'était changer la règle en cours de partie. Il n'aurait d'ailleurs pas suffi : à ce seuil, Jev ne trouvait plus que 11 défauts sur 15. Nous l'avons écarté.
La tentation était réelle : l'outil est bon marché, rapide, élégant. C'est précisément quand on a envie qu'un outil fonctionne que les règles fixées d'avance servent le plus.
Nos limites
Les écrire fait partie de la méthode.
- De petits corpus : 32 cas pour le rattachement, une centaine d'exigences pour la couverture des tests, 30 cas pour la relecture. Poser trois fois la même question ne crée pas de nouveau cas. Avec 15 cas sains, « aucune fausse alerte » reste compatible avec un taux réel de l'ordre d'une sur cinq. Nos résultats valent pour nos usages, pas pour Jev en général.
- Une version, une date :
jev-1.13.0, en octobre 2026. Le produit peut évoluer. - Des références non indépendantes : les cas, les bonnes réponses et les comparaisons ont été produits avec Claude. Les juges humains prévus n'ont pas été mobilisés. Ce biais peut favoriser Claude Code dans les comparaisons.
- Une comparaison asymétrique : dans l'essai de relecture, l'agent de Claude Code voyait tous les cas d'un coup, Jev un seul à la fois.
- Des cas en partie fabriqués : les défauts de l'essai de relecture et certains ajouts sans rapport ont été écrits pour l'essai. Ils peuvent être plus visibles que de vrais défauts.
- Un seul domaine d'usage : nous avons testé Jev sur nos besoins de contrôle de code. Ses résultats sur d'autres usages ne sont pas couverts par nos essais.
Ce que ces résultats ne disent pas
Ces résultats ne disent donc pas que Jev est un mauvais modèle. Ils disent que, sur nos usages et face à ce dont nous disposions déjà, il n'apporte pas de quoi justifier son intégration.
Cinq règles pour évaluer un composant d'IA avant de l'intégrer
1. Poser la bonne question
Pas « l'outil marche-t-il ? », mais « apporte-t-il plus que ce que nous avons déjà ? » Comparez à l'existant, sur les mêmes cas et dans les mêmes conditions : même consigne, même information.
2. Écrire les règles avant de regarder
Cas de test, bonnes réponses, seuils et verdict sont fixés avant le premier appel. Prévoyez assez de vrais cas : répéter une question n'en crée pas un nouveau. Ce qui est trouvé après coup ne compte pas.
3. Changer une seule variable à la fois, et fixer l'arrêt d'avance
Si un essai échoue, refaites-le en ne modifiant qu'une chose, et décidez avant de le relancer ce qui vous fera arrêter.
4. Tester la capacité à dire « je ne sais pas »
Glissez dans vos cas des questions sans réponse possible, offrez une vraie option « impossible à déterminer » et mesurez combien de fois elle sert. Un outil qui répond toujours avec assurance ne peut ni prouver, ni valider, ni bloquer.
5. Traiter un « non » comme un résultat
Il évite d'intégrer, de payer et de maintenir un composant sans valeur démontrée. C'est le même raisonnement que pour la gouvernance des agents IA : on n'ajoute un outil à ses processus que s'il est maîtrisé.
Le saviez-vous ?
Toute notre évaluation a tenu en une journée, pour un coût d'appel négligeable. Elle a toutefois mobilisé un dispositif outillé : des agents pour préparer les cas et les références, des contre-vérifications, des résultats scellés. Une PME peut en garder l'essentiel avec moins : une trentaine de vrais cas, les bonnes réponses écrites avant le premier essai, un seuil de réussite, et la comparaison avec l'outil déjà en place. Ce qui compte, c'est la discipline : fixer les règles avant de regarder les résultats, et s'y tenir. C'est aussi ce qui permet d'expliquer l'IA à un dirigeant sans lui vendre de promesses.
Vous évaluez un outil d'IA pour vos processus ?
Parlons-en : nous partageons volontiers notre méthode et nos critères. Pour former vos équipes à l'IA agentique, consultez nos formations.
Prendre rendez-vous30 minutes d'échange, sans engagement
Ce qu'il faut retenir
- Comparer à l'existant : un outil d'IA doit apporter plus que ce que vous avez déjà, pas seulement fonctionner.
- Fixer les règles d'avance : référence, seuils et verdict avant le premier appel ; un réglage trouvé après coup ne compte pas.
- Exiger le « je ne sais pas » : un modèle qui répond toujours avec assurance ne peut pas servir de preuve.
- Assumer le « non » : une journée d'évaluation coûte moins cher qu'un composant inutile à maintenir.
Sources
- TypeSafe — documentation, page « Models » : version
jev-1.13.0, tarif par jeton en entrée, sortie gratuite (consultée le 8 octobre 2026). - TypeSafe — « Introducing System One Models & Jev », billet de lancement : principe du modèle, temps de réponse annoncé, garantie de format.
- InfoWorld — « TypeSafe AI's new models work with machines, not humans » (17 septembre 2026).
- Essais internes Oppchain du 7 octobre 2026 : données non publiées, échange possible sur demande.
À propos de l'auteur
Frédéric Michel dirige Oppchain, cabinet et organisme de formation certifié Qualiopi spécialisé en IA agentique. Il conçoit et met en production des agents pour des PME et des ETI, et anime des ateliers de cadrage IA en comité de direction.